Atsulog#007
全体の流れ#
記事は Markdown で書いてデータベースに保存しておき,表示するたびに HTML へ変換しています.変換はサーバーで HTML の文字列まで済ませ,Mermaid の図だけをブラウザで描いています.
flowchart TD
    MD["Markdown"] --> MDAST
    subgraph Server["サーバー"]
        MDAST["mdast<br>GFM・数式・リンクカード"] -->|"remark-rehype"| HAST["hast<br>KaTeX・ハイライト・見出し"]
        HAST -->|"rehype-stringify"| HTML["HTML の文字列"]
    end
    HTML --> Q
    subgraph Browser["ブラウザ"]
        Q{"mermaid のブロックがある?"} -->|"はい"| SVG["Mermaid で SVG を描く"]
        Q -->|"いいえ"| Done["そのまま表示"]
    end
サーバーで HTML まで作っておけば,記事ページを開いたブラウザでは変換用のライブラリを動かす必要がありません.数式もこの段階で組版されるので,ページを開いた時点で本文がすべて表示されています.
unified と構文木#
変換には unified というライブラリを使っています.unified とは,文章を 構文木 に変換し,プラグインで木を加工してから,別の形式の文字列に書き出すための仕組みです.
構文木(AST,Abstract Syntax Tree)とは,文章の構造を「見出し」「段落」「強調」のような節(ノード)の親子関係で表したデータです.たとえば これは **大事** です という 1 行は,次のような木になります.
root
└─ paragraph(段落)
   ├─ text "これは "
   ├─ strong(強調)
   │  └─ text "大事"
   └─ text " です"
unified には,扱う木の種類ごとにプラグインの集まりがあります.
- remark:Markdown を扱うプラグイン群.木の形式は mdast(Markdown の構文木)
- rehype:HTML を扱うプラグイン群.木の形式は hast(HTML の構文木)
上の例は,mdast から hast に変換すると paragraph が <p> 要素に,strong が <strong> 要素になり,最後に <p>これは <strong>大事</strong> です</p> という文字列として書き出されます.
プラグインの構成#
プラグインは app/lib/markdown/markdown-rendering.ts の createProcessor で,次の順に登録しています.remark-rehype を境に,前半が mdast を扱う remark 側,後半が hast を扱う rehype 側です.(実際にはフィード用にリンクカードなどを切り替えるオプションがありますが,ここでは省いて処理の流れだけを並べています.)
unified()
  // remark 側:mdast を扱う
  .use(remarkParse)    // Markdown の文字列を mdast にする
  .use(remarkGfm)      // 表やタスクリストなどの GFM を読む
  .use(remarkMath)     // $...$ と $$...$$ を数式のノードとして読む
  .use(remarkLinkCard) // URL だけの段落をリンクカードにする(自作)
  // mdast を hast に変換する
  .use(remarkRehype, { allowDangerousHtml: true })
  // rehype 側:hast を扱う
  .use(rehypeKatex)                                 // 数式を KaTeX で組版する
  .use(rehypeHighlight, { plainText: ["mermaid"] }) // コードブロックに色を付ける
  .use(rehypeArticle)    // 見出しの ID や表の調整などの後処理(自作)
  .use(rehypeStringify); // hast を HTML の文字列にする
同じ処理は,管理画面のエディタのプレビューでも使っています.プレビューはブラウザで動くので,リンクカードは外部ページの情報を取得せず,URL だけのカードとして表示します.
HTML 文字列として描画する#
変換した HTML は,React の dangerouslySetInnerHTML でそのままページに埋め込みます.
export function MarkdownRenderer({
  content,
  cards,
  withToc = false,
}: MarkdownRendererProps) {
  const { html, toc } = renderMarkdown(content, cards); // HTML と目次を作る

  return (
    <>
      {withToc && <TableOfContents items={toc} />}
      <MermaidDiagrams html={html}>
        <div
          className="prose-site"
          dangerouslySetInnerHTML={{ __html: html }}
        />
      </MermaidDiagrams>
    </>
  );
}
dangerouslySetInnerHTML は,名前のとおり使い方を誤ると危険な機能です.文字列に <script> などが含まれていると,そのままページの一部として実行されてしまうからです.このように,ページに外から紛れ込んだスクリプトを実行させる攻撃を XSS(Cross-Site Scripting)と呼びます.
そこで,自作の rehypeArticle で次の 2 つの処理をしています.
- 生の HTML は文字として表示する:Markdown の中に書かれた HTML タグは,要素にせずにただのテキストへ置き換える
- 危険な URL を取り除く:
hrefやsrcなどの URL をreact-markdownのdefaultUrlTransformに通し,javascript:のようなスキームを空にする
visit(tree, (node, index, parent) => {
  // Raw HTML shows as text, as in react-markdown.
  if (node.type === "raw") {
    // ...このノードを,同じ文字列を持つ text ノードに差し替える
    return;
  }

  if (node.type !== "element") return;

  transformUrls(node, baseUrl); // 危険な URL を取り除く
  // ...表のセルの揃え,表を div で囲む処理,見出しの ID と目次
});
visit は,木のすべてのノードを順にたどって関数を呼ぶユーティリティです.1 回の巡回で,すべての後処理をまとめて行っています.
生の HTML が raw というノードになっているのは,remark-rehype に allowDangerousHtml: true を渡しているからです.このオプションがないと,HTML タグは変換の時点で黙って捨てられてしまいます.いったん raw ノードとして残してからテキストに置き換えることで,書いたタグが消えずに文字のまま表示されます.
対応している記法#
createProcessor で登録しているプラグインのうち,既存のライブラリをほぼそのまま使っているものを紹介します.どれも登録するだけで記法が使えるようになるので,Atsulog 側で手を加えているのは一部だけです.
GFM#
GFM(GitHub Flavored Markdown)とは,GitHub が標準の Markdown に加えた拡張記法です.remark-gfm を入れると,表,タスクリスト(- [x] 完了),取り消し線(~~text~~),URL をそのまま書いたときの自動リンクが使えるようになります.
Atsulog 側では,表を rehypeArticle で <div class="table-scroll"> に囲んでいます.列の多い表でもページの横幅を押し広げず,表だけを横にスクロールできます.
数式#
KaTeX とは,LaTeX の記法で書いた数式を HTML と CSS で組版するライブラリです.remark-math が $...$(文中),$$...$$ と ```math(独立した数式)を数式のノードとして読み取り,rehype-katex がサーバーで組版します.そのため,ブラウザで KaTeX の JavaScript を動かす必要はありません.
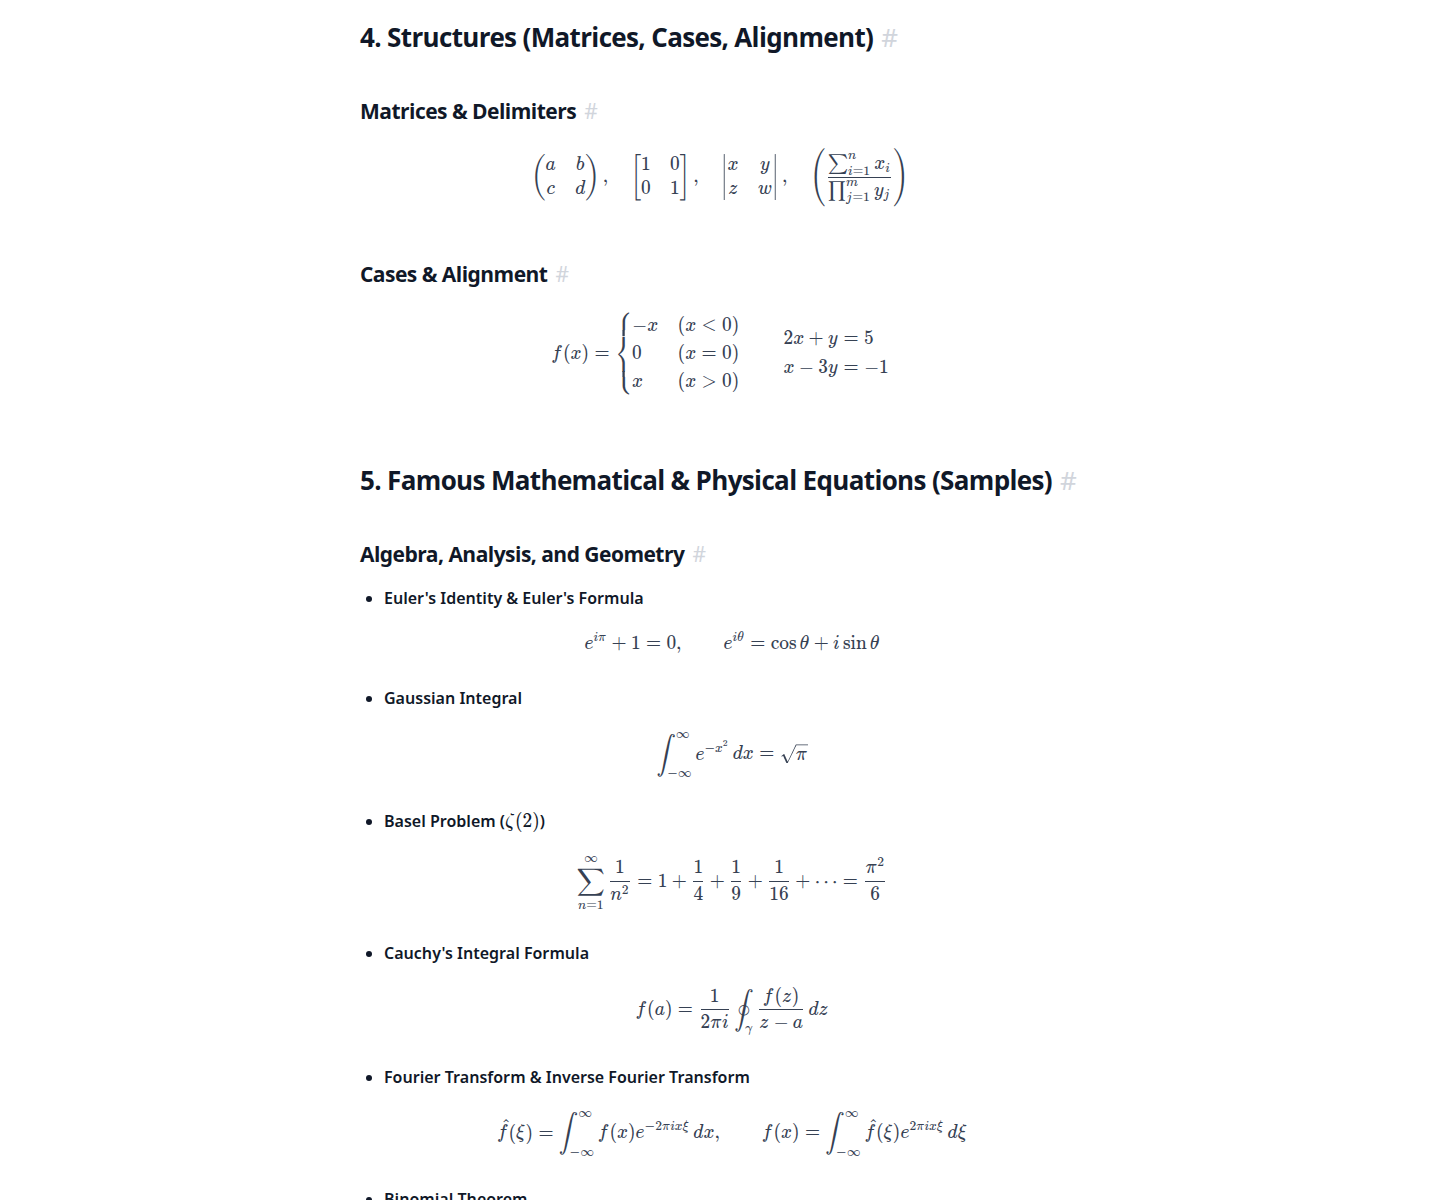
本文でドル記号を書きたいときは,数式の始まりと解釈されないように \$ とエスケープします(コードの中では不要です).
コードハイライト#
rehype-highlight は,highlight.js でコードを字句ごとに分け,<span class="hljs-keyword"> のようなクラスを付けるプラグインです.色は CSS のテーマで決まり,Atsulog では見やすさに配慮した a11y-dark を使っています.
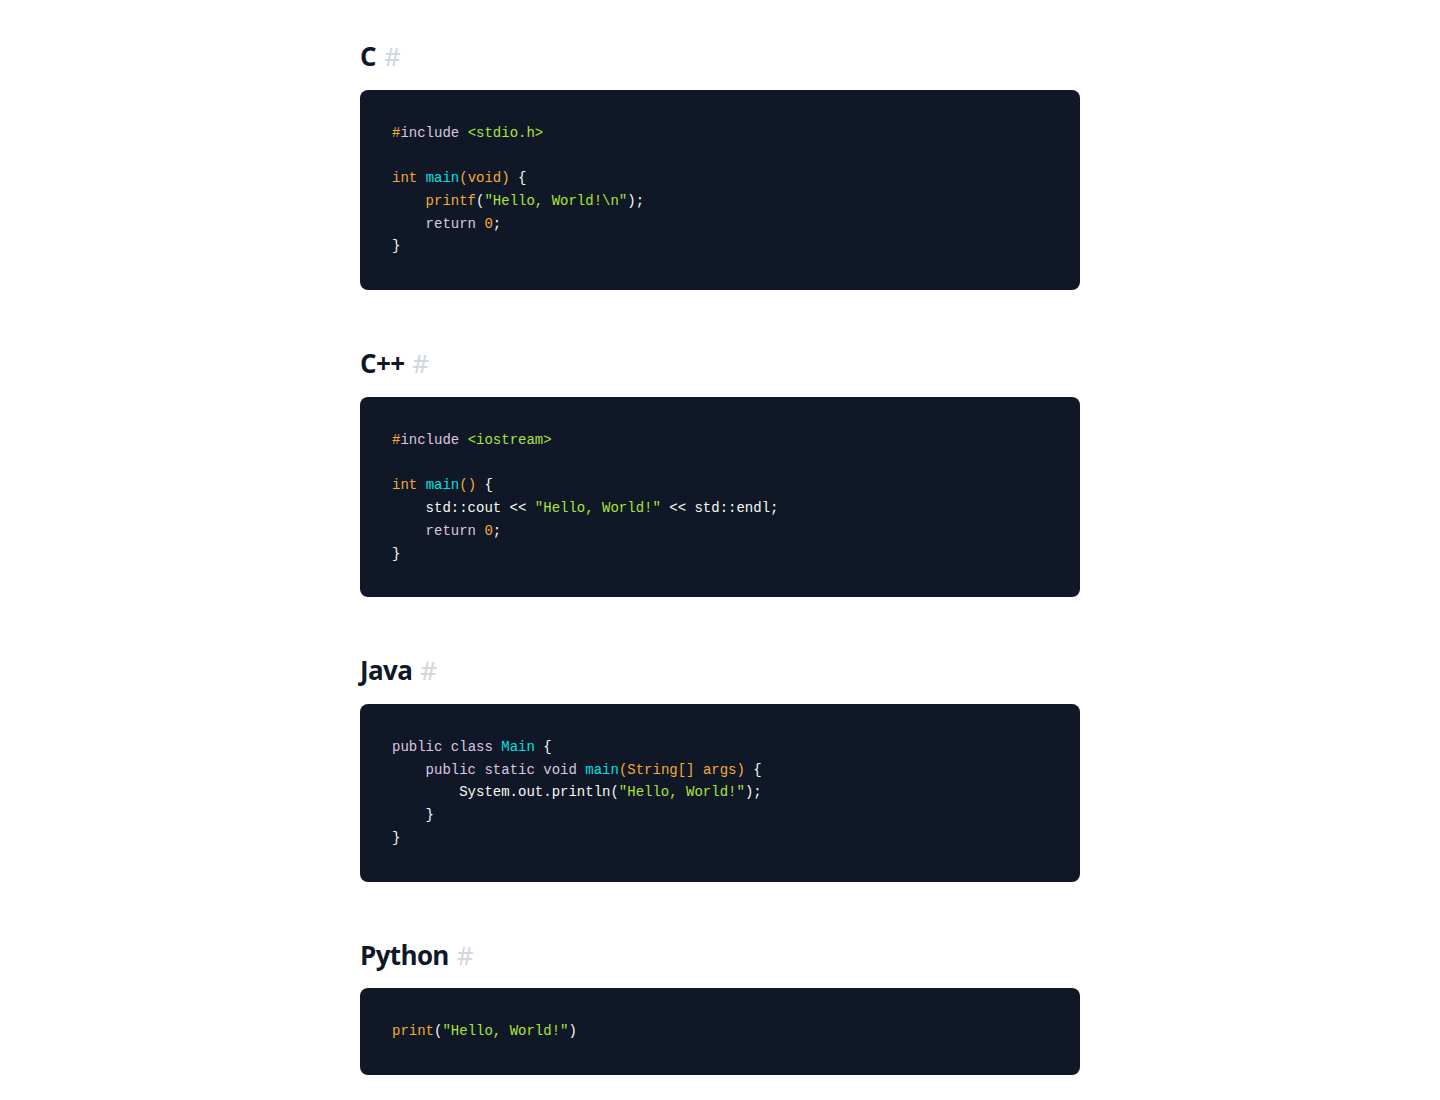
言語の自動判定は有効にしていないので,色が付くのは ```python のように言語名を書いたコードブロックだけです.また,次の 2 種類は色付けの対象から外れます.
// KaTeX first: both claim ```math fences.
.use(rehypeKatex, katex)
// Left as source for MermaidDiagrams to draw in the browser.
.use(rehypeHighlight, { plainText: ["mermaid"] })
```math:先に登録した KaTeX が数式として組版するので,ハイライトまで回らない```mermaid:色付けの<span>が入ると Mermaid が読めなくなるので,plainTextに指定して元の文字列のまま残す
見出しと目次#
見出しには,目次やリンクから飛べるように ID を付けています.
function anchorHeading(
  node: Element,
  slugger: GithubSlugger,
  toc: TocItem[],
  headingLinks: boolean,
) {
  const text = headingText(node.children).trim(); // 見出しの文字列
  const id = slugger.slug(text);                  // 文字列から ID を作る
  node.properties.id = id;
  if (node.tagName === "h2" || node.tagName === "h3") {
    // ...目次に「深さ・文字列・ID」を追加する
  }
  if (headingLinks) node.children.push(headingLink(id)); // 横に # のリンクを付ける
}
- ID:
github-sluggerで,GitHub と同じ規則で見出しの文字列から ID を作る.同じ見出しが 2 回出てきたときは,-1のような番号を付けて区別してくれる - 目次:
##と###の見出しだけを集め,記事の先頭に目次として表示する
Mermaid#
```mermaid のコードブロックは,Mermaid で図にしています.Mermaid とは,フローチャートやシーケンス図などを,テキストの記法から SVG の図として描くライブラリです.
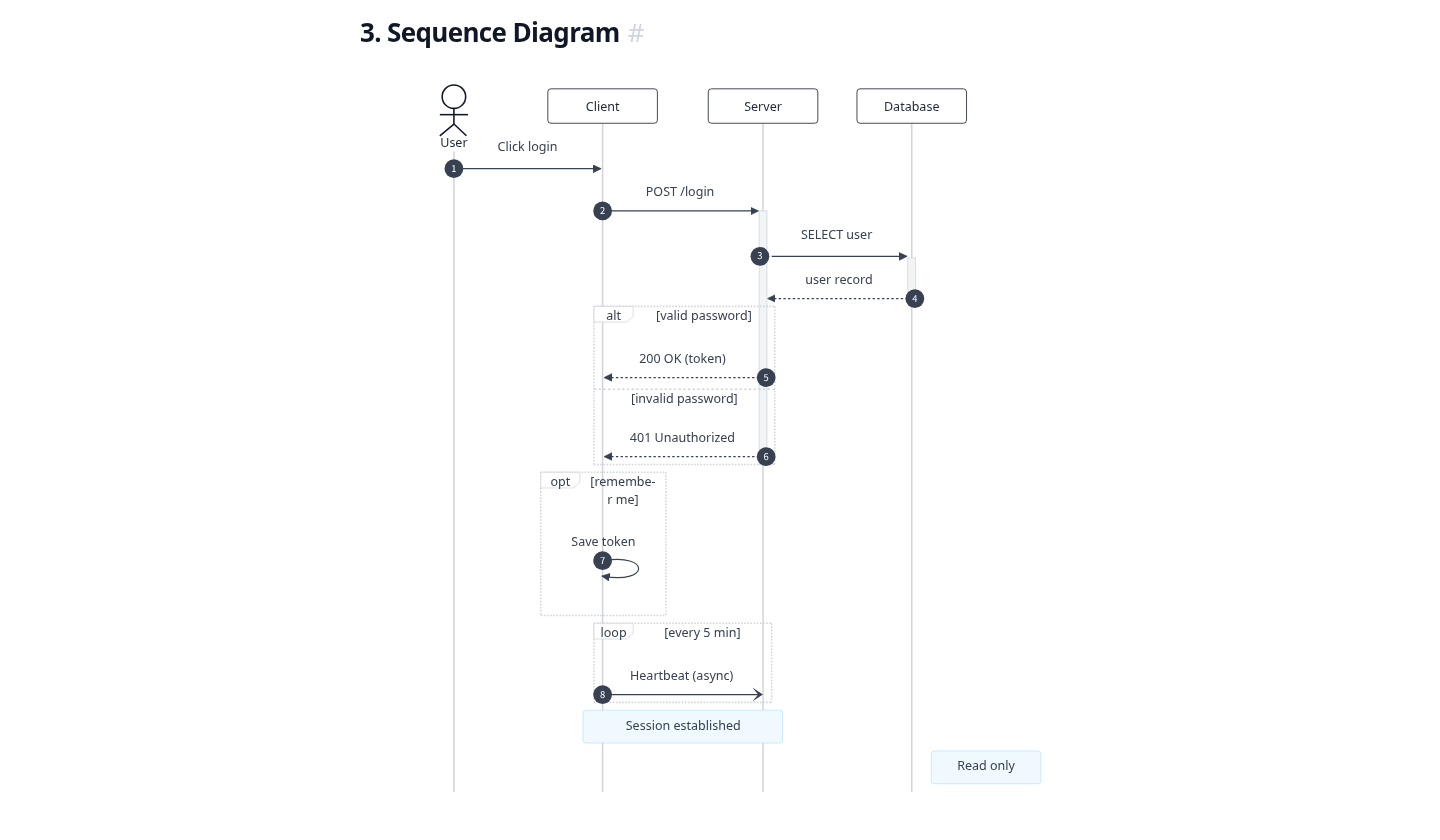
Mermaid は図を描くときにブラウザの DOM を使う(ラベルの文字の大きさを測るなど)ので,サーバーではなくブラウザで動かしています.処理は Client Component の MermaidDiagrams が行います.Client Component とは,ブラウザでも JavaScript が実行される React のコンポーネントです.
1 つのコードブロックは,次のように処理されます.
flowchart TD
    A["mermaid のコードブロック"] --> B["parse で構文を確かめる"]
    B -->|"成功"| C["render で SVG を描く"]
    C --> D["コードブロックを図に置き換える"]
    B -->|"失敗"| E["コードの下にエラーを表示"]
useEffect(() => {
  // ...本文から mermaid のコードブロック(codes)を探し,なければ何もしない

  let cancelled = false;

  (async () => {
    const mermaid = await loadMermaid(); // 初めて必要になったときに読み込む

    for (const code of codes) {
      if (cancelled) return; // HTML が変わっていたら打ち切る
      // ...parse で確かめてから render し,コードブロックを SVG に置き換える
      // ...失敗したらコードの下にエラーを表示する
    }
  })();

  return () => {
    cancelled = true; // 古い HTML に対する描画を止める
  };
}, [html]);
- 必要になるまで読み込まない:Mermaid は大きなライブラリなので,
import("mermaid")の 動的インポート で,図のあるページを開いたときにだけ読み込む.動的インポートとは,プログラムの実行中に必要になった時点でモジュールを読み込む書き方 - 先に構文を確かめる:構文の誤った図をいきなり
renderするとページに不要な要素が残るので,先にparseで確かめる.失敗したときは元のコードを残したまま,その下にエラーメッセージを表示する - 古い描画を止める:エディタのプレビューで本文を書き換えたときなど,描画の途中で HTML が変わると,
cancelledを立てて古い HTML への描画を打ち切る securityLevel: "strict":ラベルに書いた HTML タグをエスケープし,クリック時にスクリプトを呼ぶ機能も無効にする
変換結果のキャッシュ#
記事ページはリクエストのたびに描画されるので,そのたびに Markdown を変換し直すと無駄が大きくなります.そこで,変換結果をメモリ上の Map に 64 件まで保存しています.
function render(
  // ...変換器,本文,リンクカードの情報,フィード用の基準 URL
): RenderedMarkdown {
  // ...基準 URL,リンクカードの情報,本文をつないでキー(key)を作る
  const cached = cache.get(key);
  if (cached !== undefined) return cached; // 同じ入力なら前回の結果を返す

  // ...unified で変換し,HTML と目次を rendered にまとめる

  // 64 件を超えたら,いちばん古く入れたものを捨てる
  if (cache.size >= CACHE_LIMIT) cache.delete(cache.keys().next().value!);
  cache.set(key, rendered);
  return rendered;
}
キャッシュのキーには,本文だけでなくリンクカードの情報も含めています.最初はカードの情報がまだ取得できておらず,URL だけのカードで描画されることがあるからです.本文だけをキーにすると,後でカードの情報が届いても古い結果が返り続けてしまいます.
JavaScript の Map は,要素を入れた順番を覚えています.cache.keys().next() で最初の要素を取り出せば最も古く入れた結果を消せるので,簡単な FIFO(First In, First Out,先入れ先出し)のキャッシュになります.