Atsulog#008
Contents
リンクカードとは#
本文に URL だけを 1 行で書くと,リンク先のページのタイトル,説明,画像を取得して,カードの形で表示します.
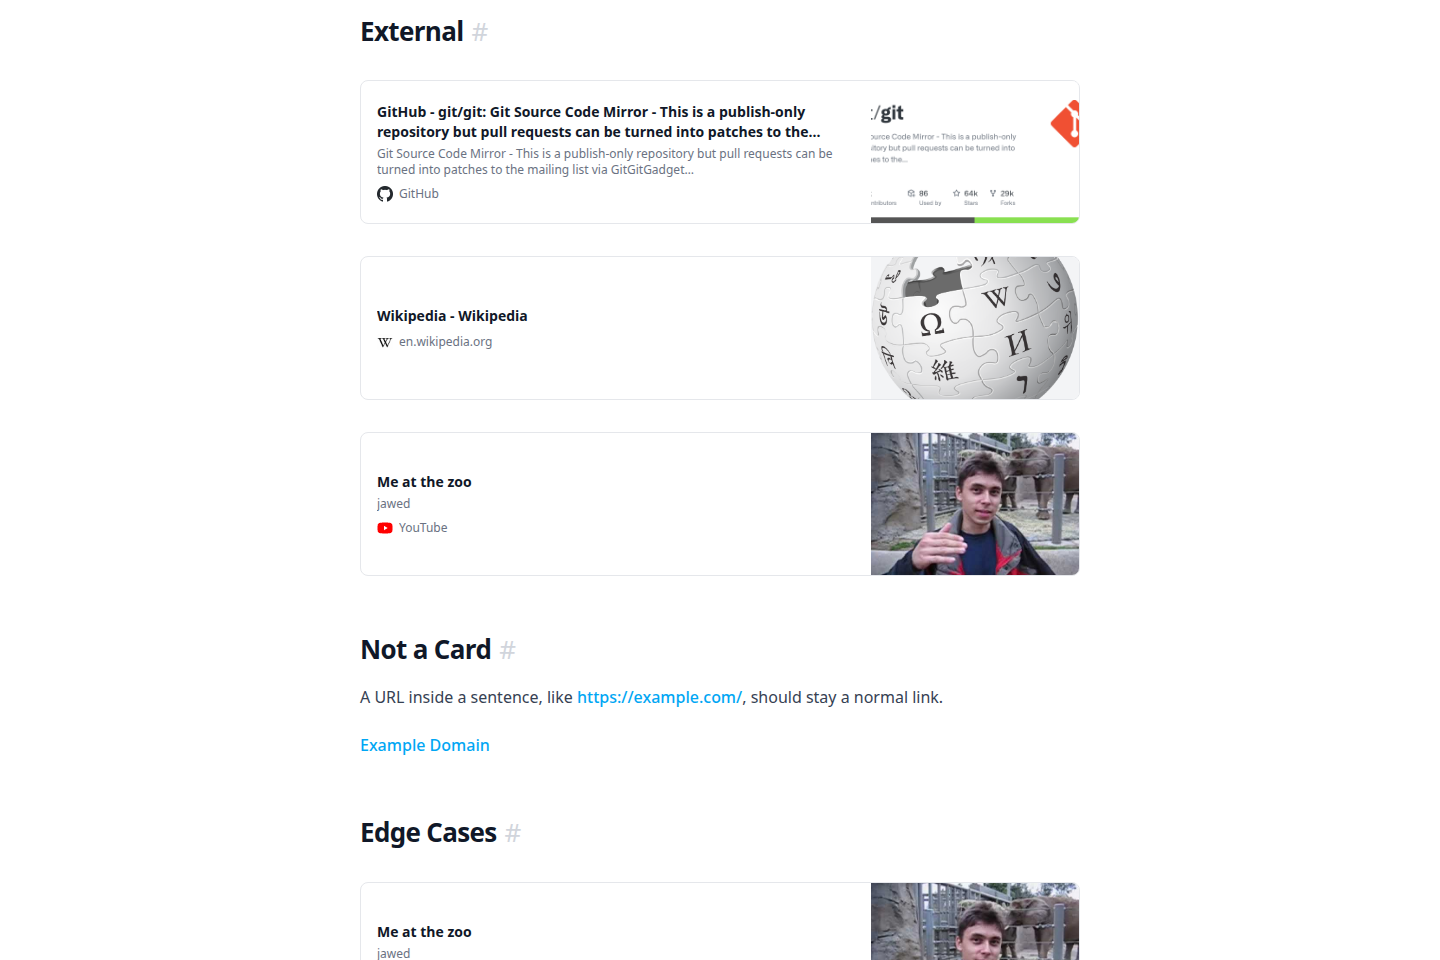
カードに使う情報は,リンク先のページの <head> にある OGP(Open Graph Protocol)の <meta> タグから読み取ります.OGP とは,og:title や og:image などのタグでページのタイトルや代表画像を示しておく仕組みで,SNS にリンクを貼ったときのカード表示にも使われています.
<head>
  <meta property="og:title" content="ページのタイトル">
  <meta property="og:image" content="https://example.com/ogp.png">
</head>
カードになる条件#
カードになるのは,次の条件をすべて満たす段落だけです.
- 段落の中身がリンク 1 つだけで,リンクの文字列が URL そのもの
- URL が
http://かhttps://で始まる - Atsulog 自身のページではない
- 箇条書きや引用の中ではなく,本文の一番外側にある段落
- 1 つの記事で 20 個まで
↓これはカードになる
https://github.com/git/git

文中の https://example.com/ はカードにならない

[Example Domain](https://example.com/) もカードにならない
- 文中の URL はそのまま:文中の URL や,文字列を指定したリンクは普通のリンクのまま
- 箇条書きや引用の中は対象外:カードを置くと,そのブロックのレイアウトが崩れるから
- Atsulog 自身のページは対象外:取得しても自分のサイトの情報が出るだけだから
この判定は linkCardUrlOf という 1 つの関数にまとめています.この関数は,次の 2 か所で使われます.
- どの URL を取得するか を決めるとき
- どの段落をカードとして描画するか を決めるとき
同じ関数で判定しているので,「取得したのに描画されない」「描画するのに取得していない」という食い違いが起きません.
全体の流れ#
記事ページを表示するときの流れは,次のとおりです.
sequenceDiagram
    participant P as Article page
    participant S as Card store
    participant W as Linked site
    P->>P: Collect card URLs
    P->>S: getLinkCards(urls)
    alt Fresh card in cache
        S-->>P: Cached card
    else Missing or stale
        S->>W: GET (timeout 5 s)
        W-->>S: HTML head
        Note over S: Save to link-cards.db
        S-->>P: Card (waits up to 3 s)
    end
    P->>P: Render HTML with cards
- 本文を Markdown として読み,カードにする URL を集める
- URL ごとに,キャッシュにまだ新しいカードがあるか調べる
- ないもの,古くなったものだけをリンク先から取得する
- カードの情報を Markdown の変換に渡し,HTML に組み込む
リンク先が遅いと,記事ページの表示まで遅くなってしまいます.そこで,取得は 最大 3 秒 だけ待つことにしています.3 秒に間に合わなかったカードは,次のように表示します.
- 古い情報があるとき:古い情報のままカードを表示する
- 何もないとき:URL とホスト名だけの簡易表示にする
3 秒を過ぎても取得自体は裏で続いています.終わった結果はキャッシュに保存されるので,次にページを開いたときにはきちんとしたカードが表示されます.
ページ情報の取得#
リンク先の取得は,app/lib/link-card/link-card-fetch.ts の fetchLinkCard が行います.この関数は例外を投げません.失敗したときも,「失敗した」という情報を持つカードを返します.
head だけを読む#
カードに必要な情報は,すべて HTML の <head> の中にあります.<body> まで全部読むのは無駄なので,</head> か <body> が見えた時点で読むのをやめています.ただし,</head> がいつまでも見つからないページもありうるので,読む量は 1MB まで,待つ時間は 5 秒まで に制限しています.
サーバーからのレスポンスは,一度に全部届くのではなく,チャンク と呼ばれる小さなかたまりに分かれて少しずつ届きます.そこで,チャンクを 1 つ読むたびに </head> が含まれていないかを調べます.
while (size < MAX_HTML_BYTES) {                // 最大 1MB まで
  const { done, value } = await reader.read(); // 次のチャンクを読む
  if (done || !value) break;                   // 最後まで読んだら終わり
  chunks.push(value);
  size += value.length;

  const text = carry + LATIN1.decode(value);   // バイト列を仮に文字列にする
  if (HEAD_END.test(text)) break;              // </head> か <body> が見えたら終わり
  carry = text.slice(-CARRY);                  // 末尾の 8 文字を次に持ち越す
}
このループには,2 つの工夫があります.
1 つ目は carry です.チャンクの区切りは HTML のタグとは無関係なので,</head> が 2 つのチャンクにまたがって </he と ad> のように分かれて届くことがあります.チャンクを 1 つずつ調べるだけでは,これを見落としてしまいます.そこで,前のチャンクの末尾 8 文字を carry として残しておき,次のチャンクの先頭につなげてから調べています.探す文字列(</head と <body)はどちらも 8 文字より短いので,境目で切れても必ず見つかります.
2 つ目は Latin-1 です.届くのはバイト列なので,</head> を探すにはいったん文字列に変える必要があります.しかし,この時点ではページの文字コード(UTF-8 や Shift_JIS など)がまだわかりません.そこで,1 バイトをそのまま 1 文字にする文字コードである Latin-1 で,仮に文字列にしています.
- ASCII の文字は正しく読める:
</head>のような ASCII の文字は,UTF-8 でも Shift_JIS でも同じバイトで表されるので,Latin-1 で読んでも正しく見つかる - 文字が途中で切れない:UTF-8 の日本語のように,1 文字を複数のバイトで表す マルチバイト文字 は,チャンクの境目で 1 文字が分断されることがある.Latin-1 なら 1 バイトが常に 1 文字なので,この問題が起きない
日本語の部分は Latin-1 では文字化けしますが,ここでは </head> を探すだけなので問題ありません.
読み終えたら,本当の文字コードで文字列にし直します.文字コードは,次の順で探して最初に見つかったものを使います.
- レスポンスの
Content-Typeヘッダーのcharset(例:text/html; charset=Shift_JIS) - HTML の先頭 1024 バイトにある
<meta charset> - どちらもなければ UTF-8
情報の読み取り#
読み取った <head> は,hast に変換してから値を取り出します.文字列のまま正規表現で探すよりも,属性の順番や引用符の違いに左右されず,確実に <meta> タグを見つけられます.
同じ情報が複数のタグに書かれていることもあるので,次の順で探して最初に見つかったものを使います.
- タイトル:
og:title→twitter:title→<title> - 説明:
og:description→twitter:description→description - サイト名:
og:site_name.なければホスト名 - 画像:
og:image→og:image:url→twitter:image - アイコン:
<link rel="icon">.なければapple-touch-iconなどほかのアイコン
取り出した値は,カードに載せる前に次のように整えます.
- 空白をまとめる:改行や連続する空白を 1 つの空白にする
- 長すぎるものを切り詰める:タイトルは 200 文字,説明は 300 文字まで
- 相対 URL を絶対 URL に直す:
/ogp.pngのような相対 URL は,リダイレクトされた後の最終的な URL を基準にhttps://example.com/ogp.pngの形にする
画像とアイコンは,https の URL のものだけを使います.HTTPS のページの中で http の画像を読み込もうとすると,混在コンテンツ(mixed content)としてブラウザに止められてしまうからです.
また,アイコンが宣言されていないときに,/favicon.ico があるだろうと推測して使うこともしません.実際には存在しなければ,壊れた画像が表示されてしまうからです.
YouTube は oEmbed を使う#
YouTube の URL だけは,ページを読まずに oEmbed を使います.oEmbed とは,URL を渡すと,そのコンテンツのタイトルやサムネイル画像などを JSON で返してくれる仕組みです.YouTube を特別扱いしているのは,次の理由です.
- サーバーからだと画像が取れない:YouTube は,アクセス元によって
og:imageのない簡略版のページを返すことがあり,サーバーからのアクセスがこれに当たる - ページが大きすぎる:YouTube のページは
<head>だけで 780KB ほどあるが,oEmbed の応答は 1KB ほどで済む
カードの説明の欄には,動画の説明文ではなくチャンネル名を入れています.
SSRF 対策#
SSRF とは#
リンクカードの取得は,記事に書かれた URL へ サーバーが アクセスする処理です.このような処理では,SSRF(Server-Side Request Forgery)に注意が必要です.
SSRF とは,サーバーに細工した URL へアクセスさせ,外からは届かない内部のサービスにリクエストを送らせる攻撃です.サーバーの中や同じネットワークには,外からはアクセスできないが,サーバー自身からならアクセスできるサービスがあります.たとえば次のようなものが狙われます.
http://127.0.0.1:3000/:サーバー自身で動いている管理用のサービスなどhttp://169.254.169.254/:クラウドの メタデータサーバー.サーバーの設定や認証情報を返す
下の図のように,攻撃者は内部のサービスに直接はアクセスできません.しかし,URL を渡してサーバーにアクセスさせれば,サーバーを踏み台にして内部まで届いてしまいます.
flowchart TD
    A["攻撃者"] -->|"細工した URL"| S["サーバー"]
    subgraph inner["サーバーの中・同じネットワーク"]
        S -->|"GET"| L["127.0.0.1:3000<br>管理用サービス"]
        S -->|"GET"| M["169.254.169.254<br>メタデータサーバー"]
    end
    A -.-x|"直接は届かない"| M
内部のサービスは「内側からのアクセスなら安全」と考えて認証を省いていることが多いので,サーバーからのリクエストにはそのまま応答してしまいます.
Atsulog で記事を書くのは自分だけですが,念のため,内部のアドレスには接続できないようにしています.
遮断するアドレス#
遮断しているアドレスは,大きく分けて次のとおりです.
- 自分自身を指すアドレス:
127.0.0.0/8,::1など - プライベートアドレス:家庭や社内のネットワークで使うアドレス.
10.0.0.0/8,192.168.0.0/16,fc00::/7など - リンクローカルアドレス:同じネットワークの中だけで使うアドレス.
169.254.0.0/16,fe80::/10 - その他:マルチキャストや予約済みのアドレスなど,インターネット上の通常の通信先ではないもの
接続のたびに調べる#
URL の文字列を見て判定するだけでは,SSRF は防げません.たとえば http://evil.example.com/ という普通のドメインでも,DNS でそれが 127.0.0.1 を指すように設定されていれば,内部に届いてしまいます.そこで,接続を作る瞬間に,実際に接続する IP アドレス を調べています.
これには HTTP エージェント を使います.HTTP エージェントとは,接続の作り方(ホスト名から IP アドレスを調べる 名前解決 や,ソケットの開き方)を決めるオブジェクトです.Node.js の HTTP クライアントである undici の Agent に,チェックを組み込んだものを用意して,リンクカードの取得ではこれを使っています.
チェックは,次の 2 か所で行っています.
flowchart TD
    A["URL のホスト名"] --> B{"IP アドレスが<br>直接書かれている?"}
    B -->|Yes| C{"guardedAgent の connect<br>遮断対象?"}
    B -->|No| D["DNS で名前解決"]
    D --> E{"guardedLookup<br>遮断対象を含む?"}
    C -->|No| F["接続する"]
    E -->|No| F
    C -->|Yes| X["接続せずに失敗"]
    E -->|Yes| X
// 名前解決の結果を調べる
const guardedLookup = (hostname, options, callback) => {
  dnsLookup(hostname, options, (error, address, family) => {
    // 結果 (addresses) に遮断するアドレスが 1 つでもあれば失敗にする
    if (addresses.some((entry) => isBlockedAddress(entry.address))) {
      return callback(new BlockedAddressError());
    }
    callback(null, address, family);
  });
};

// ソケットを開く関数.名前解決には guardedLookup を使う
const connect = buildConnector({ lookup: guardedLookup });

export const guardedAgent = new Agent({
  // undici が接続を作るときに呼ぶ入口
  connect(options, callback) {
    // IP アドレスの直書きは名前解決を通らないので,ここで調べる
    if (isIP(options.hostname) && isBlockedAddress(options.hostname)) {
      return callback(new BlockedAddressError());
    }
    connect(options, callback); // 上の connect でソケットを開く
  },
});
- 名前解決の結果を調べる(
guardedLookup):ホスト名が普通のドメインのときは,DNS で解決した後の IP アドレスを調べる.1 つのドメインが複数の IP アドレスを返すこともあるので,1 つでも遮断対象が含まれていれば失敗にする - IP アドレスの直書きも調べる(
guardedAgentのconnect):http://10.0.0.1/のように IP アドレスが書かれた URL は名前解決を通らないので,接続の直前に直接調べる
このように接続を作る部分でチェックしているので,次の 2 つの抜け道もふさがれます.
- リダイレクト:外部のページから内部のアドレスへリダイレクトされても,リダイレクト先への接続を作るときにもう一度チェックされる
- DNS リバインディング:同じドメインの DNS の答えを短時間で切り替え,チェックのときは外部の IP アドレスを,接続のときは内部の IP アドレスを返す攻撃.Atsulog では,チェックした IP アドレスにそのまま接続するので,すり替える隙がない
キャッシュ#
失敗も保存する#
取得したカードは,link-cards.db に URL をキーとして JSON で保存しています.取得に失敗したときも,「失敗したカード」として保存します.このように,失敗した結果もキャッシュすることを ネガティブキャッシュ といいます.
失敗を保存しないと,応答しないリンク先があったときに,記事が開かれるたびに取得を試み,毎回 5 秒のタイムアウトを待つことになります.失敗を保存しておけば,有効期限の間は取得を試みずに済みます.
有効期限#
キャッシュの有効期限は,結果によって変えています.
- 成功:30 日.ページのタイトルや画像はそう頻繁には変わらない
- 失敗(404 や HTML でないページなど):1 日.すぐに直る見込みは薄い
- 一時的な失敗(タイムアウト,接続拒否,5xx,429 など):10 分.少し待てば成功する可能性がある
一時的な失敗も,すぐに取得し直したいところです.しかし,閲覧のたびに取得し直すと,応答しないサーバーへのリンクで毎回 5 秒待つことになるので,10 分は間を空けています.なお,SSRF 対策で遮断したアドレスは,何度試しても結果が変わらないので,一時的な失敗には含めず通常の失敗として扱います.
期限の切れたカードは,すぐには捨てません.取得し直している間の つなぎ として使い,3 秒以内に新しい情報が届かなければ,古いカードをそのまま表示します.
flowchart TD
    A["キャッシュを調べる"] --> B{"カードがある?"}
    B -->|No| C["取得する"]
    B -->|Yes| D{"期限内?"}
    D -->|Yes| E["そのまま表示"]
    D -->|No| C
    C --> F{"3 秒以内に届いた?"}
    F -->|Yes| G["新しいカードを表示"]
    F -->|No| H["古いカードか簡易表示"]
同じ URL を同時に取得しない#
人気の記事が同時に何人にも開かれると,同じ URL の取得が同時にいくつも走ってしまいます.そこで,取得中の処理を Map に入れて共有しています.
ここで Map に入れているのは,取得の結果そのものではなく Promise です.Promise とは,「いずれ結果が返ってくる処理」を表すオブジェクトです.取得中の Promise を共有すれば,後から来たリクエストは新しく取得を始めずに,すでに走っている取得の結果を一緒に待てます.
/** One fetch per URL, shared by every request that wants it. */
const inFlight = new Map<string, Promise<LinkCard>>(); // URL → 取得中の処理

function refresh(url: string): Promise<LinkCard> {
  const running = inFlight.get(url);
  if (running) return running; // 取得中なら,その結果を一緒に待つ

  const task = fetchLinkCard(url)
    .then((card) => {
      writeCard(card);         // 結果を link-cards.db に保存
      return card;
    })
    .finally(() => inFlight.delete(url)); // 終わったら一覧から外す

  inFlight.set(url, task);     // 取得中の一覧に登録する
  return task;
}
これで,記事が多くの人に同時に開かれても,リンク先へのアクセスは URL ごとに 1 回で済みます.
カードの組み立て#
カードの HTML は,buildLinkCard で hast の要素として組み立て,Markdown の変換の途中で元の段落と差し替えています.出来上がる HTML は次のような形です.
<a class="link-card" href="..." target="_blank" rel="noopener noreferrer">
  <div class="link-card-text">
    <div class="link-card-title">タイトル</div>
    <div class="link-card-description">説明</div>
    <div class="link-card-site"><img class="link-card-favicon"> サイト名</div>
  </div>
  <img class="link-card-image">
</a>
- 情報がないときも同じ枠を使う:エディタのプレビューや取得に失敗したときは,タイトルの位置に URL を,サイト名の位置にホスト名を入れた簡易表示にする
- 別タブで開く:
target="_blank"で新しいタブで開く.さらにrel="noopener noreferrer"を付けて,開いた先のページから元のページを操作できないようにする - 画像は遅延読み込み:
loading="lazy"で,画面に近づいてから画像を読み込む