Atsulog#009
機械向けに配信しているもの#
人が読む HTML のページとは別に,プログラムが読むためのファイルもいくつか配信しています.
/feed.xml:新着記事を フィードリーダー に知らせる Atom フィード/sitemap.xml:検索エンジンに公開ページの一覧を伝える サイトマップ/robots.txt:クローラーに巡回してほしくない場所を伝えるファイル- 各ページの
<meta>タグ:SNS でリンクを共有したときのカード表示(OGP)
フィードリーダーとは,複数のサイトの更新をまとめて購読できるアプリやサービスのことです.クローラー とは,検索エンジンなどがページを自動で巡回して集めるためのプログラムです.
Atom フィード#
フィード とは,サイトの新着情報を決まった形式で並べた XML ファイルです.形式には RSS と Atom があり,Atsulog では Atom(RFC 4287)を使っています.Atom は日付の書き方や必須の要素が仕様で厳密に決められているので,リーダーによる解釈の違いが起きにくい形式です.
/feed.xml は Next.js の Route Handler で作っています.Route Handler とは,ページではなく任意のレスポンスを返す API のようなものです.フォルダ名を feed.xml にすると,そのまま /feed.xml という URL になります.
// app/feed.xml/route.ts
export async function GET() {
  // 公開済みの記事を新しい順に 20 件,本文ごと取得する
  const entries = await getLatestArticleDetails(siteConfig.feedEntriesCount);

  return new NextResponse(buildAtomFeed(entries), {
    headers: { "Content-Type": "application/atom+xml; charset=utf-8" },
  });
}
フィードの中身は,app/lib/feed/atom-feed.ts で文字列を組み立てて作っています.1 記事分の <entry> は次のような形になります.
<entry>
<id>https://atsulog.com/articles/20261101222711</id>
<title>Atsulog#004</title>
<link rel="alternate" type="text/html" href="https://atsulog.com/articles/20261101222711"/>
<published>2026-11-01T13:27:11.091Z</published>
<updated>2026-11-02T13:52:27.149Z</updated>
<category term="Security"/>
<category term="Cookie"/>
<category term="JWT"/>
<category term="Next.js"/>
<content type="html"><blockquote>...</content>
</entry>
<id>:記事を一意に表す ID.記事の URL をそのまま使う<published>と<updated>:Atom が要求する RFC 3339 形式の日時.保存している日時をDateで読み直し,toISOString()で形をそろえる<category>:記事のカテゴリとタグ.重複は取り除く<content>:記事の本文を HTML にしたもの.リーダーの中で全文を読めるように,要約ではなく本文全体を入れている
フィード全体の <updated> は,含まれる記事の更新日時のうち最も新しいものにしています.どれか 1 つの記事が更新されれば,フィードも更新されたことになります.
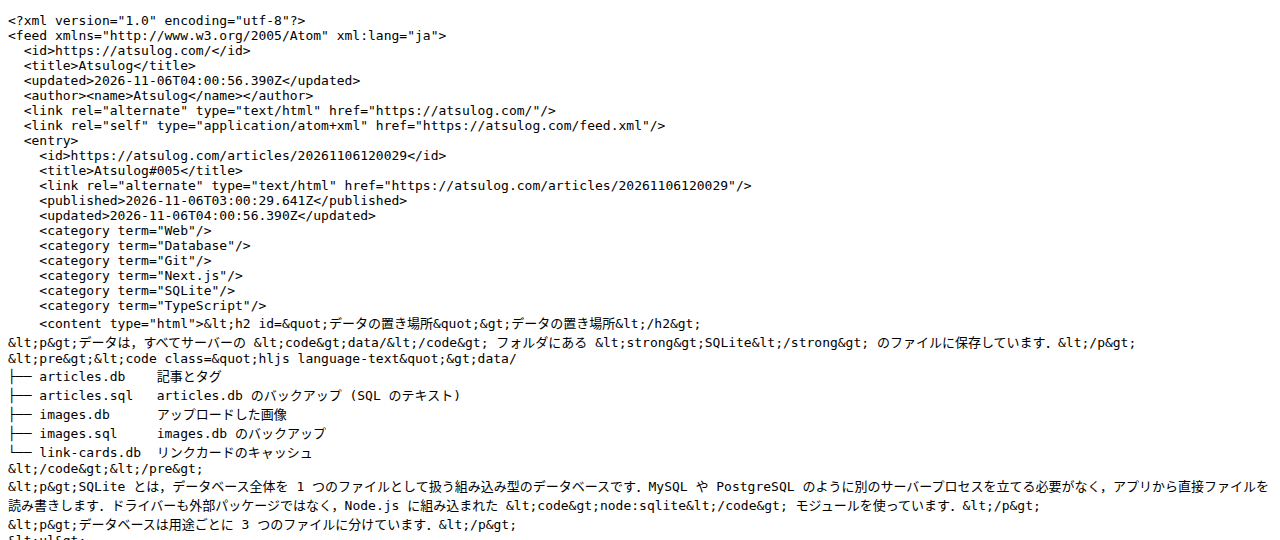
実際の /feed.xml をブラウザで開くと,次のようになります.<content> の中の本文は,次に説明するエスケープによって <h2> のような形になっています.
XML のエスケープ#
タイトルや本文を XML に埋め込むときは,エスケープ が必要です.エスケープとは,< や & のように XML で特別な意味を持つ文字を,< や & のような別の表記に置き換えることです.
/** Characters XML 1.0 does not allow, even when escaped. */
const INVALID_XML_CHARS =
/[\u0000-\u0008\u000B\u000C\u000E-\u001F]/g;
function escapeXml(value: string): string {
return value
.replace(INVALID_XML_CHARS, "") // XML で使えない文字を消す
.replace(/[&<>"']/g, (char) => XML_ESCAPES[char]); // 特殊な 5 文字を置き換える
}
XML 1.0 には,エスケープしても使えない文字があります.タブや改行を除く制御文字などで,これが 1 文字でも混ざるとフィード全体が読めなくなります.そこで,置き換えの前にこれらの文字を取り除いています.本文の HTML も,この関数でエスケープしてから <content type="html"> に入れています.
フィード用のレンダリング#
フィードの本文は,サイトの記事ページとは少し違う設定で HTML にしています.フィードリーダーでは,サイトの CSS も JavaScript も読み込まれないからです.
- 数式:KaTeX の見た目は CSS とフォントに頼っているので,フィードでは MathML だけを出力する.MathML とは,数式を表すための HTML の要素で,ブラウザが自力で描画できる
- リンクカード:カードの見た目も CSS に頼っているので,フィードではただのリンクにする
- 見出しのリンク:記事ページでは見出しの横に
#のリンクを付けているが,フィードではこれが文字としてそのまま見えてしまうので付けない - 相対 URL:
/images/...のような相対 URL は,リーダーではどのサイトのものかわからない.記事の URL を基準にhttps://atsulog.com/images/...のような絶対 URL に直す
export function renderFeedMarkdown(content: string, baseUrl: string): string {
  feedProcessor ??= createProcessor({
    katex: { output: "mathml" }, // 数式は MathML だけにする
    linkCards: false,            // リンクカードを作らない
    headingLinks: false,         // 見出しに # を付けない
  });
  // baseUrl を渡すと,相対 URL が絶対 URL に直される
  return render(feedProcessor, content, undefined, baseUrl).html;
}
サイトマップ#
サイトマップ とは,サイトにあるページの URL と更新日時を並べた XML ファイルです.検索エンジンは,リンクをたどるだけでは見つけにくいページもこれで知ることができます.
Next.js では,app/sitemap.ts で URL の配列を返すと,それを /sitemap.xml として配信してくれます.
export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  // "published" keeps the about page, which "public" leaves out.
  const { items } = await searchArticles({}, "published");

  return [
    { url: siteConfig.url },                 // トップページ
    { url: `${siteConfig.url}/articles` },   // 記事一覧
    { url: `${siteConfig.url}/privacy` },    // プライバシーポリシー
    ...items.map((article) => ({
      url: `${siteConfig.url}/articles/${article.slug}`,
      lastModified: article.modifiedAt,      // 記事の更新日時
    })),
  ];
}
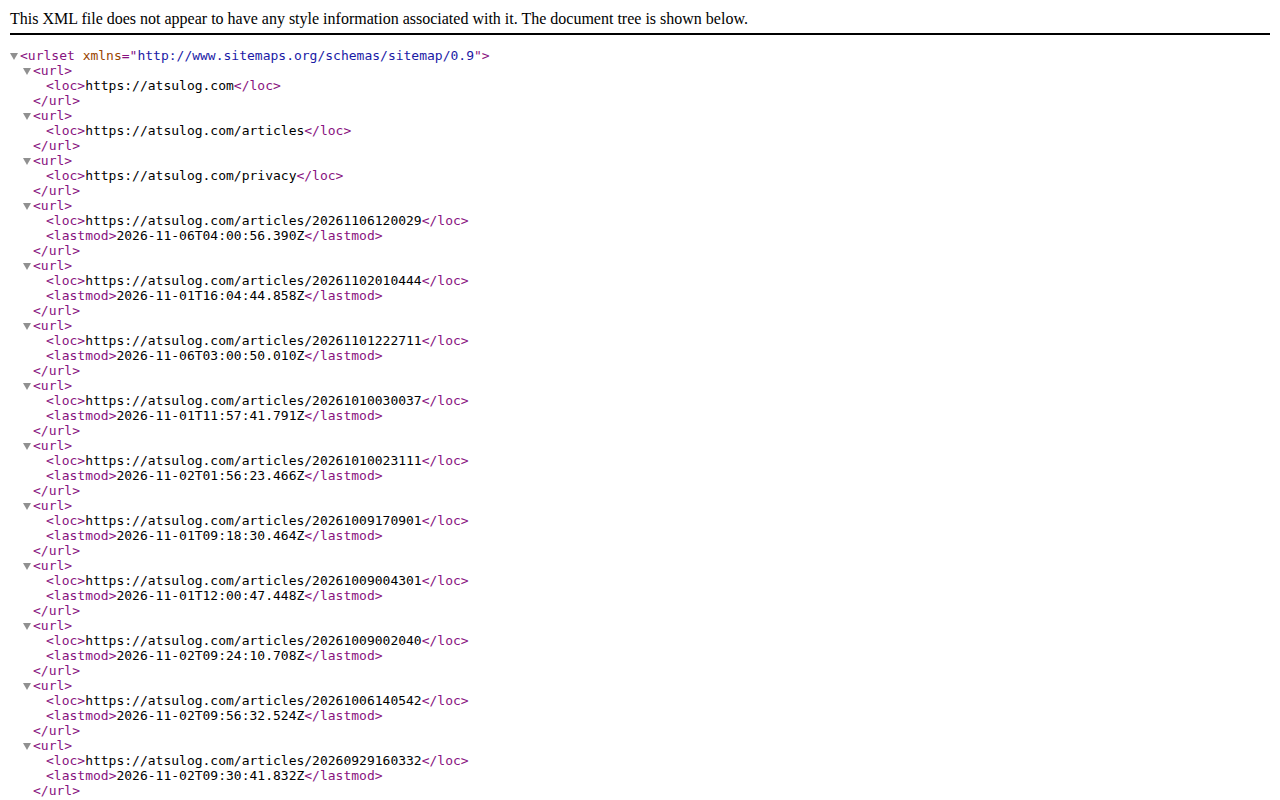
配信される /sitemap.xml は次のようになります.記事のページには,<lastmod> として更新日時が付きます.
robots.txt#
app/robots.ts から /robots.txt を作っています.
export default function robots(): MetadataRoute.Robots {
  return {
    rules: { userAgent: "*", allow: "/", disallow: ["/admin", "/login"] },
    sitemap: `${siteConfig.url}/sitemap.xml`, // サイトマップの場所も伝える
  };
}
配信される /robots.txt は次のようになります.
User-Agent: *
Allow: /
Disallow: /admin
Disallow: /login

Sitemap: https://atsulog.com/sitemap.xml
管理画面 /admin とログイン画面 /login は,検索結果に出る意味がないので巡回の対象から外しています.ただし,robots.txt はクローラーへのお願いにすぎず,アクセスを禁止するものではありません.管理画面は,ログインしていなければ開けないようにして別に守っています.
OGP と Twitter Card#
OGP(Open Graph Protocol)とは,ページのタイトル,説明,画像などを <meta> タグで示しておき,SNS やチャットにリンクを貼ったときにカードとして表示させるための仕組みです.X(旧 Twitter)では,同じ目的の Twitter Card という独自のタグも読みます.
Next.js では,ページごとに metadata を返すと,これらのタグを <head> に出力してくれます.公開ページで共通の項目は,app/lib/page-metadata.ts の buildPageMetadata にまとめています.
- タイトルと説明は,ページごとに渡す
- 共有用の画像は,すべてのページで
share-image.png(1200 × 630)を使う - Twitter Card は,大きな画像を表示する
summary_large_imageにする - 記事ページでは,種類を
articleにし,公開日時も入れる
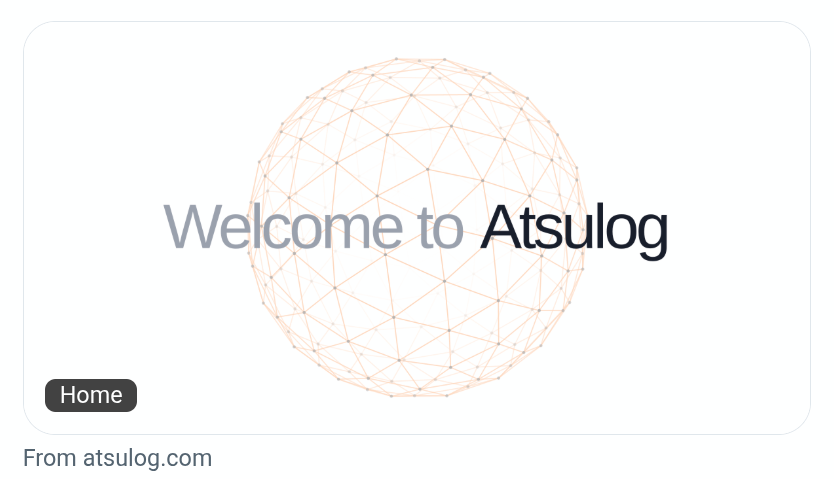
X にトップページのリンクを貼ると,次のようなカードで表示されます.
記事ページの generateMetadata では,下書きの記事のタイトルが漏れないようにしています.
const detail = await getArticleBySlug(slug);

// A draft must not leak its title, even though the page itself 404s.
if (!detail || !detail.metadata.published) {
  return { title: `Article Not Found | ${siteConfig.title}` };
}
下書きのページ自体は 404 になりますが,メタデータはページ本体とは別に作られます.ここで記事が存在するかどうかしか見ていないと,404 のページの <title> に下書きのタイトルが出てしまうので,公開済みかどうかも確かめています.